java八股文前五十道题
java八股文前五十道题
Java八股文200道
一、Java基础篇
1、JDK、JRE、JVM区别
1
2
3
4
5
Java虚拟机(JVM)是Java平台的一部分,负责执行Java字节码。
Java运行环境(JRE)是运行Java程序所需的环境。
Java开发工具包(JDK)是Java的开发环境。

JDK包含JRE,JRE包含JVM。
2、八种基本数据类型
1
2
3
4
5
6
7
8
基本数据类型
整数类型: byte、short、int、long
浮点类型: float、double
布尔类型: boolean
字符类型: char

注: 整形数据默认为 int 数据类型,浮点型默认为 double 数据类型;如果要表示
long 型数据或 float 型数据,要在相应的数值后面加上 l、L 或 f、F,否则会出现编译问题。
3、break 和 continue、return 的区别
1
2
3
4
5
6
7
8
9
使用场合不同:
break 可用于 switch 结构和循环结构中;
continue 只能用于循环结构中;
return 只能用于方法中;

作用不同
break 语句终止某个循环,程序跳转到循环块外的下一条语句。
continue 跳出本次循环,进入下一次循环
return 用来定义方法返回值或结束方法;
4、说说&和&&的区别 | ||
1
2
3
4
5
1.&和&&都可以用作逻辑与的运算符,两者都表示逻辑与(and),当运算符两边的表达式的结果都为true时,整个运算结果才为true,否则,只要有一方为false,则结果为false;

2.&&还具有短路的功能,即如果第一个表达式为false,就不再计算第二个表达式,直接返回false;

3.&&不支持位运算符 &支持位运算。
5、==和equals区别?
1
2
3
4
5
6
7
8
9
10
11
12
equals()是Object类中的一个方法
==在java中只是一个运算符号

==既可以比较基本类型的值是否相等,也可以比较两个对象的地址是否相等。
Object的equals()只能比较两个对象的地址是否相等,但该方法可以被重写,修改比较规则。

void m1(){
	String s1 = new String("abc");
	String s2 = new String("abc");
	sout(s1==s2);//false
	sout(s1.equals(s2));//true
}
6、switch语句支持的数据类型有哪些?
1
2
3
4
5
6
7
8
9
10
11
12
byte  short  int  char  String  enum

i = 1;
switch (i):
case 1:
	sout(1);
	break;
case 2:
	sout(2)
	break;
default:
	sout('其他');
7、什么是面向对象编程?面向对象的特点
1
2
3
面向对象编程(OOP)是一种编程范式,它将程序中的数据和操作数据的方法封装成对象,通过对象之间的交互来实现程序功能。
OOP的核心特点包括封装、继承和多态。
8、值传递和引用传递的区别
1
2
3
4
当我们调用一个有参函数的时候,会把实际参数传递给形式参数。但是,在程序语言中,这个传递过程中传递的两种情况,即值传递和引用传递。

值传递是指在调用函数时将实际参数复制一份传递到函数中,这样在函数中如果对参数进行修改,将不会影响到实际参数。
引用传递是指在调用函数时将实际参数的地址直接传递到函数中,那么在函数中对参数所进行的修改,将影响到实际参数。
9、对象的创建方式有哪些?
1
2
3
4
5
使用new调用构造器创建对象;
使用反射的方式创建对象;
使用clone方法创建对象;
使用反序列化的方式创建对象;
使用工厂模式创建对象;
10、方法的重写和方法的重载的区别?
1
2
3
4
5
6
7
方法的重载:
在同一个类中,多个方法的方法名相同,参数不同的现象。
原则:方法名相同,参数不同。

方法的重写:
子类继承父类,在子类中对继承的父类的方法进行重新定义的现象。
原则:方法名相同,参数相同,返回值类型相同,访问修饰符访问范围大于等于父类的。
11、基本类型和包装类的区别?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
Java提供了基本数据类型,并且提供了包装类型。(拆箱和装箱机制)

Byte(对应 byte)
Short(对应 short)
Integer(对应 int)
Long(对应 long)
Float(对应 float)
Double(对应 double)
Character(对应 char)
Boolean(对应 boolean)

1. 存储方式:
- 基本数据类型:它们直接在栈内存中分配空间,存储的是具体的值。
- 包装类:它们是类,所以它们作为对象在堆内存中分配空间。包装类实际上是对基本数据类型的封装,每个包装类都包含了对应的基本数据类型的值,以及其他的一些方法(如类型转换、比较等)。
2. 默认值:
- 基本数据类型:在声明但未初始化时,它们会有默认值(如`int`为0,`boolean`为`false`等)。
- 包装类:在声明但未初始化时,它们的默认值是`null`,因为它们实际上是对象。
3. 方法:
- 基本数据类型:它们没有方法,因为它们不是对象。
- 包装类:它们提供了许多有用的方法,如类型转换(`Integer.parseInt()`)、比较(`Integer.compare()`)等。
4. 泛型:
- 由于泛型在Java中不能用于基本数据类型(如`List<int>`是无效的),我们通常使用包装类(如`List<Integer>`)来创建泛型集合。
12、什么是装箱和拆箱?
1
2
3
4
5
6
7
8
Java 5.0引入了一个特性,称为自动装箱(autoboxing)和拆箱(unboxing),它允许在基本数据类型和它们的包装类之间进行自动转换。

例如,你可以直接将一个`int`值赋给一个`Integer`对象,或者将一个`Integer`对象赋给一个`int`变量,而无需显式地进行转换。但是,这种自动转换可能会带来性能开销,特别是在涉及大量数据或循环时。

int i = 1;
Integer j = 1;
i = j; //自动拆箱
i = Integer.parseInt(j);
13、final、finally、finalize区别?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
1、final
1.1 修饰变量,包含静态和非静态
如果final修饰的是一个基本类型,就表示这个变量被赋予的值是不可变的,即它是个常量。
1.2 修饰方法
当定义一个方法被final修饰时,表示此方法不可以被子类重写,但是依旧可以被子类继承使用
1.3 修饰类
其实用于final修饰的类我们很熟悉,因为我们最常用的String类就是final修饰的,由于final类不允许被继承,就意味着它不能再派生出新的子类,不能作为父类被继承

2、fnally
finally是什么呢?是Java的一种异常处理机制。finally只能用在try/catch语句中,并且是附带着的一个语句块,表示这段语句最终总是被执行。

3、finalize
最后,我们来看一下finalize,他是一个方法,隶属于java.lang.Object类。
此方法是GC运行机制的一部分,它的设计目的是保证对象在被垃圾收集前完成特定资源的回收。
14、深拷贝和浅拷贝
1
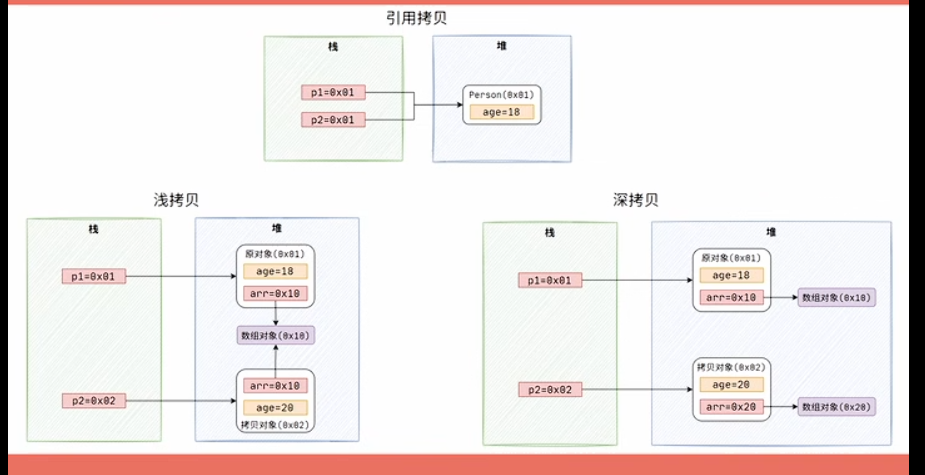
引用拷贝:只是复制对象的地址并不会创建一个新的对象
1
2
浅拷贝会创建一个新的对象 并进行属性复制 对引用类型的属性只会复制其对象地址
深拷贝则是完全复制整个对象包括引用类型的属性
1
2
3
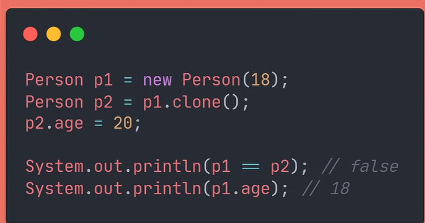
public class Object{
	protected native Object clone() throws CloneNotSuppportedException
}
1
2
3
4
5
6
7
8
9
10
11
深拷贝(Deep Copy)和浅拷贝(Shallow Copy)是在复制对象或数据结构时所使用的两种不同的拷贝方法,它们之间的区别主要在于拷贝的程度和对原始对象内部结构的影响。
1.1 浅拷贝(Shallow Copy)
浅拷贝是指创建一个新对象,这个对象有着原始对象属性值的一份精确拷贝。对于基本数据类型的成员变量,浅拷贝会直接复制其值;对于引用类型的成员变量,浅拷贝只是复制了引用(即内存地址),而不是复制引用的对象本身。因此,如果原始对象和复制对象的引用类型成员变量指向同一个对象,修改其中一个对象的引用类型成员变量会影响另一个对象
实现:Object的clone方法属于浅拷贝。
1.2 深拷贝(Deep Copy)
深拷贝不仅复制对象的基本类型成员变量,还会复制对象中的引用类型成员变量。对于引用类型的成员变量,深拷贝会创建一个新的对象来保存这些引用类型的成员变量。这样,原始对象和复制对象在内存中是完全独立的,修改其中一个对象的引用类型成员变量不会影响另一个对象
实现:
(1)重写Object的clone方法
对于深拷贝,可以在clone()方法中对引用类型成员变量再次调用clone()方法
(2)将对象序列化后反序列化,可以创建一个全新的对象,实现深拷贝
15、什么是泛型?什么是泛型擦除?
1
2
3
4
泛型(Generics)的本质是参数化类型。简单来说,泛型就是允许在定义类、接口或方法时使用类型参数,这个类型参数可以在使用的时候指定具体类型。泛型的出现,使得我们不必为每一种类型去写一个独立的类或方法,而是通过一个通用的代码结构来处理不同类型的数据。

泛型擦除(Type Erasure)是Java编程语言在泛型实现中的一种机制。它指的是在Java编译器将带有泛型信息的源代码编译成字节码的过程中,泛型类型信息会被擦除,泛型类型参数会被替换为它们的限定类型(通常是它们的上界,如果没有指定上界,则默认为Object)。这个过程发生在编译时,而不是运行时。
泛型擦除 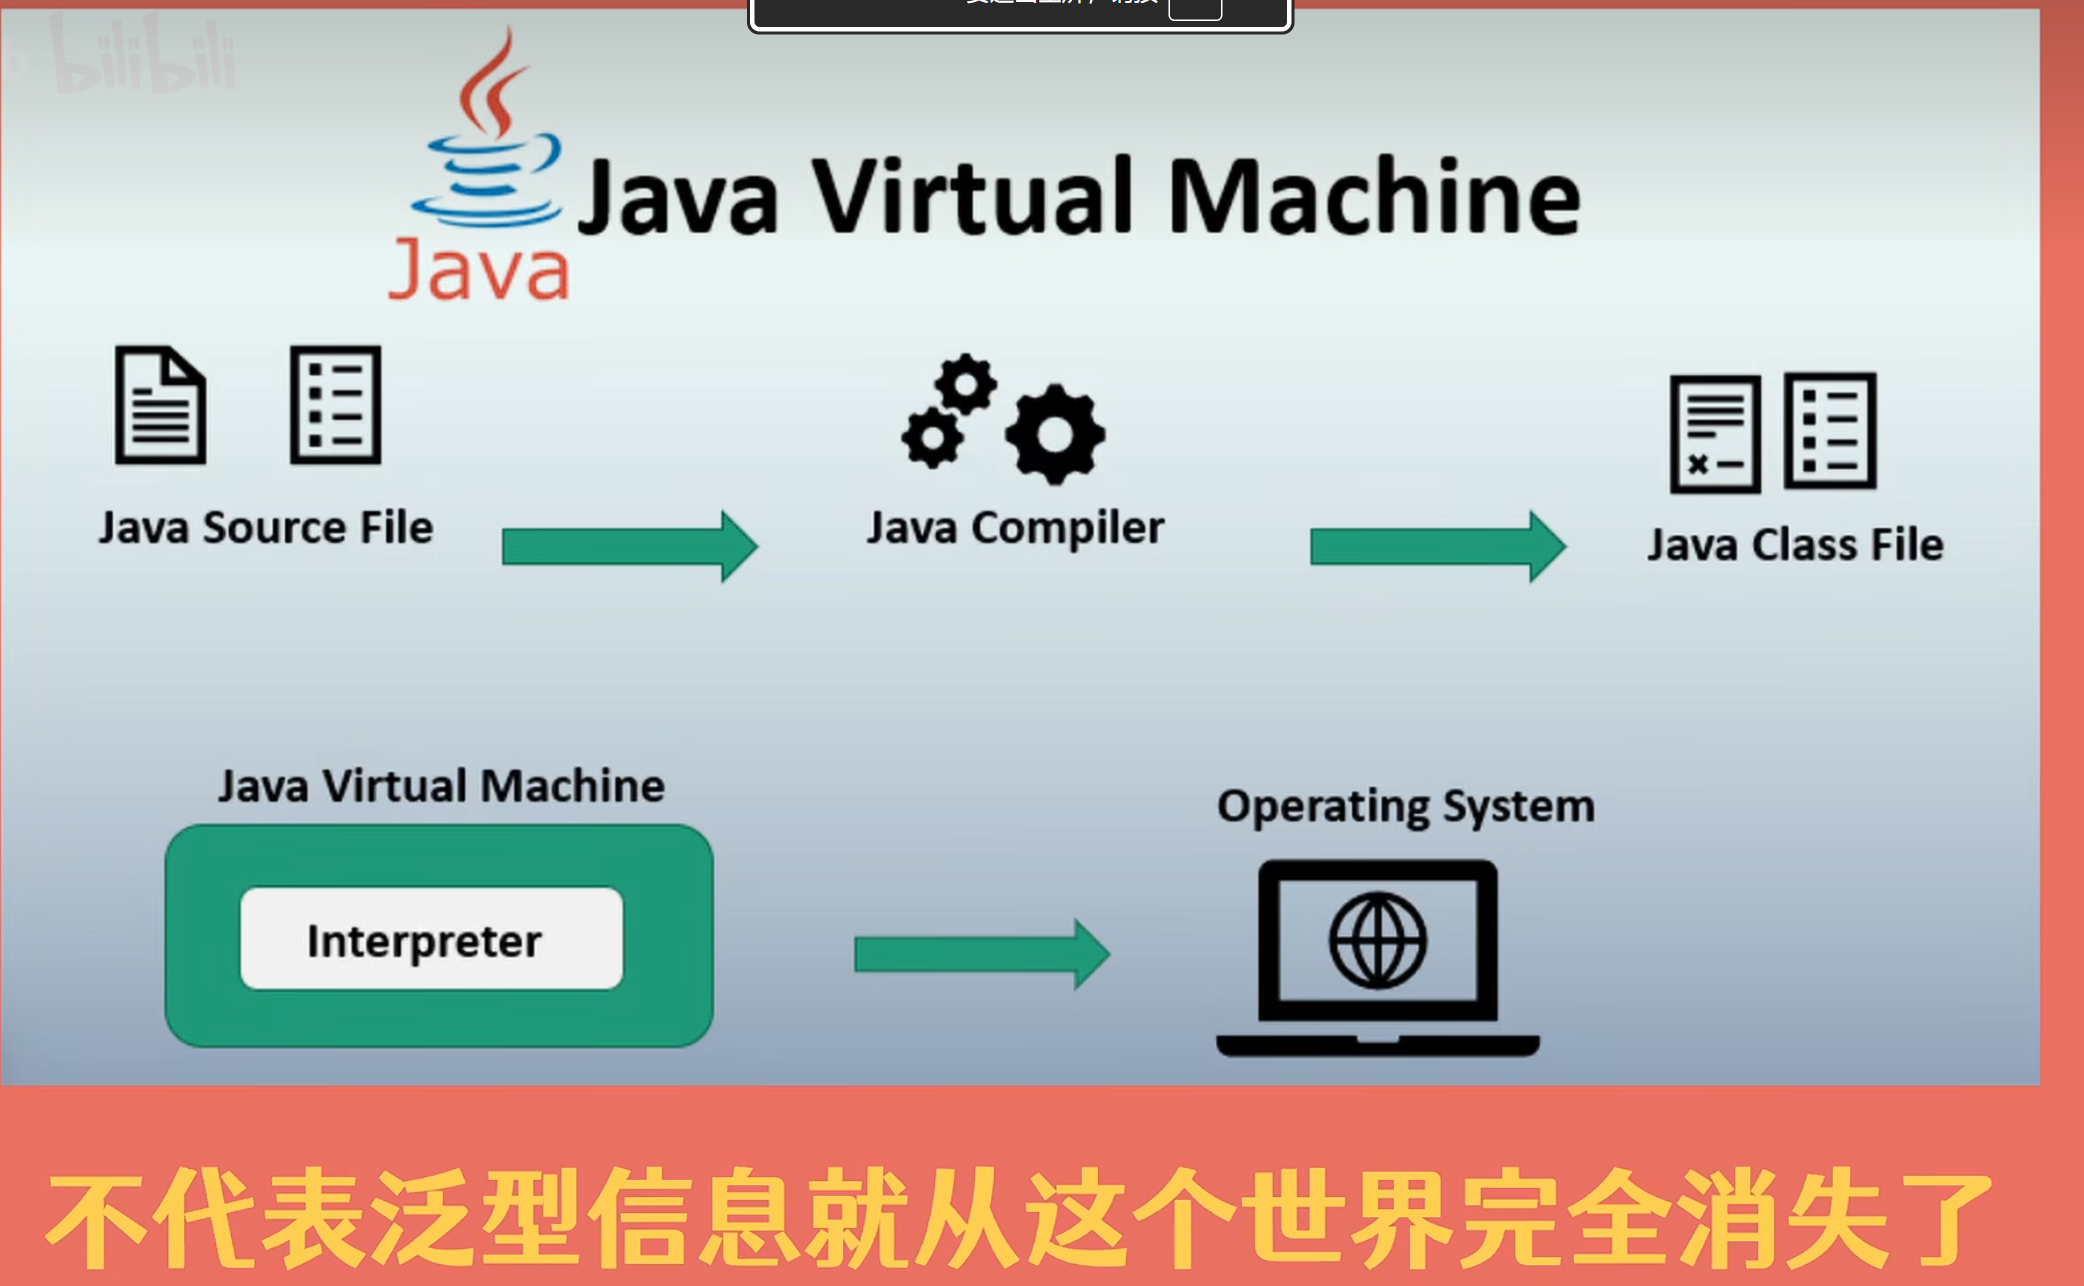
16、异常的处理方式有哪些?
1
2
3
4
5
6
7
8
9
10
11
1、声明异常(throws)
定义:
在方法签名中使用throws关键字声明该方法可能抛出的异常类型。
用途:
当一个方法内部发生异常,但该方法不想或不能处理该异常时,可以将异常抛给方法的调用者。

2、捕获异常(try-catch)
定义:
使用try-catch语句块来捕获并处理可能抛出的异常。
用途:
允许开发者在代码执行过程中捕获到异常并进行处理,从而防止程序崩溃。
try-catch常见的题 面试题一
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
public static void main(String[] args){
    int result = test1();
    System.out.println(result);
}

public static int test1(){
    int i = 1;
    try{
        i++;
        System.out.println("try block, i = "+i);
    }catch(Exception e){
        i--;
        System.out.println("catch block i = "+i);
    }finally{
        i = 10;
        System.out.println("finally block i = "+i);
    }
    return i;
}
try block, i = 2
finally block i = 10
10
面试题2
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
public static void main(String[] args){
    int result = test2();
    System.out.println(result);
}

public static int test2(){
    int i = 1;
    try{
        i++;
        System.out.println(1/0);//抛出异常,即直接出现异常,异常类型是Exception
    }catch(Exception e){
        i--;
        System.out.println("catch block i = "+i);
    }finally{
        i = 10;
        System.out.println("finally block i = "+i);
    }
    return i;
}
catch block i = 1
finally block i = 10
10
面试题三
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
public static void main(String[] args){
    int result = test3();
    System.out.println(result);
}

public static int test3(){
    int i = 1;
    try{
        i++;
        System.out.println("try block, i = "+i);
        return i;
    }catch(Exception e){
        i ++;
        System.out.println("catch block i = "+i);
        return i;
    }finally{
        i = 10;
        System.out.println("finally block i = "+i);
    }
}

try block, i = 2
finally block i = 10
2
面试题4
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
public static int test4(){
    int i = 1;
    try{
        i++;
        System.out.println("try block, i = "+i);
        return i;//这个时候是把i的值存储起来
    }catch(Exception e){
        i++;
        System.out.println("catch block i = "+i);
        return i;
    }finally{
        i++;
        System.out.println("finally block i = "+i);
        return i;
    }
}

3
总结
1
2
3
4
5
6
7
8
9
10
11
如果在带有方法的返回值的方法中定义try.. catch语句时,执行顺序:

1、不管有没有出现异常,finally块中代码都会执行;

2、当try和catch中有return时,finally仍然会执行;

3、如果在finally之前遇到了return语句(此时并不会返回结果,而是先把要返回的值保存起来,不管

finally中的代码怎么样,返回的值都return时刻的值);

4、finally中最好不要包含return,否则程序会提前退出,返回值不是try或catch中保存的返回值
17、throw和thows区别?
1
2
3
throw和throws在Java异常处理中扮演着不同的角色。
throw用于手动抛出异常对象,而throws用于声明方法可能抛出的异常类型。
在实际开发中,它们通常一起使用,以实现代码的健壮性和可维护性。
异常的分类,及常见异常? 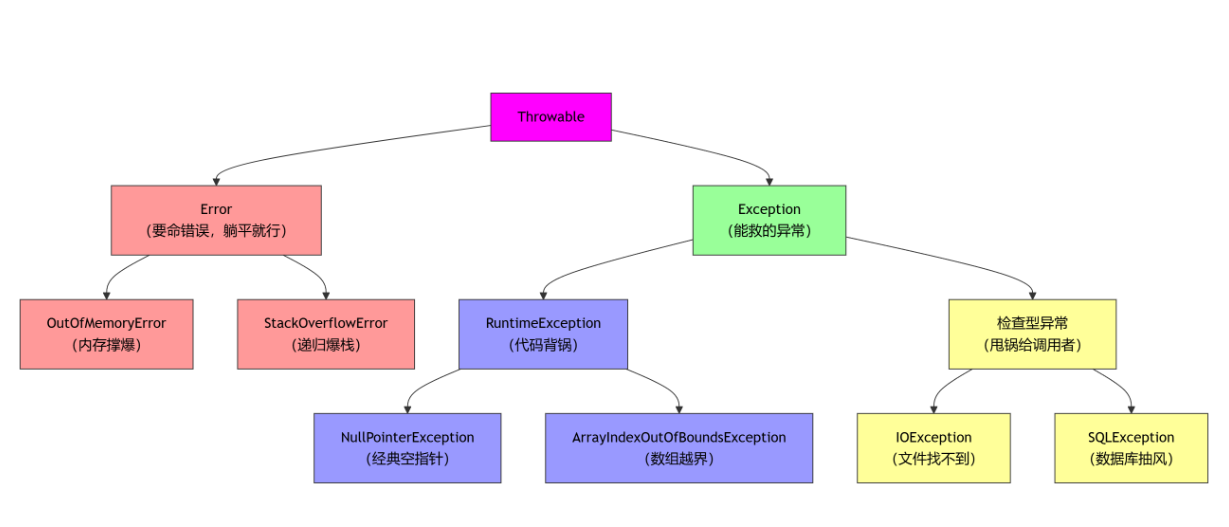
18、常用的排序算法有哪些?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
Java中常用的排序算法有多种,每种算法都有其独特的实现方式和适用场景。以下是一些常见的Java排序算法:

1、冒泡排序(Bubble Sort):
冒泡排序是一种简单的排序算法,它重复地遍历要排序的数列,一次比较两个元素,如果它们的顺序错误就交换位置。
时间复杂度:O(n^2)(平均和最坏情况)
空间复杂度:O(1)
稳定性:稳定
public static void bubbleSort(int[] arr) {
        int n = arr.length;
        // 外层循环:控制排序轮数
        for (int i = 0; i < n - 1; i++) {
            // 内层循环:两两比较,大的往后冒
            for (int j = 0; j < n - 1 - i; j++) {
                if (arr[j] > arr[j + 1]) {
                    // 交换两个数
                    int temp = arr[j];
                    arr[j] = arr[j + 1];
                    arr[j + 1] = temp;
                }
            }
        }
}

2、选择排序(Selection Sort):
选择排序的基本思想是每次从待排序的元素中选出最小(或最大)的一个元素,存放在序列的起始位置,直到全部待排序的元素排完。
时间复杂度:O(n^2)(平均、最坏和最好情况)
空间复杂度:O(1)
稳定性:不稳定
public static void selectionSort(int[] arr) {
        int n = arr.length;
        // 外层循环:控制已排序区间
        for (int i = 0; i < n - 1; i++) {
            // 假定当前i位置是最小值下标
            int minIndex = i;

            // 内层循环:找未排序区间的最小值
            for (int j = i + 1; j < n; j++) {
                if (arr[j] < arr[minIndex]) {
                    minIndex = j;
                }
            }

            // 把找到的最小值 和 当前i位置交换
            int temp = arr[i];
            arr[i] = arr[minIndex];
            arr[minIndex] = temp;
        }
    }
3、插入排序(Insertion Sort):
插入排序的基本思想是将一个元素插入到已经排序好的部分,直到所有元素排序完成。直接插入排序是插入排序的粗暴实现。
时间复杂度:O(n^2)(平均和最坏情况),O(n)(最好情况)
空间复杂度:O(1)
稳定性:稳定
4、希尔排序(Shell Sort):
希尔排序是插入排序的一种更高效的改进版本,也称为缩小增量排序。它将整个待排序的记录序列分割成为若干子序列分别进行直接插入排序,待整个序列中的记录“基本有序”时,再对全体记录进行依次直接插入排序。
时间复杂度:O(n log n)(平均情况),最坏情况可以达到O(n^2),取决于增量序列的选择。
空间复杂度:O(1)
稳定性:不稳定
5、归并排序(Merge Sort):
归并排序是一种分治算法,将数组分成两半,分别排序后再合并两个已排序的数组。
时间复杂度:O(n log n)(平均、最坏和最好情况)
空间复杂度:O(n)(需要额外的空间来存储临时数组)
稳定性:稳定
6、快速排序(Quick Sort):
快速排序也是一种分治算法,它通过选择一个“基准”元素,将数组分为两部分,然后分别排序这两部分。
时间复杂度:O(n log n)(平均情况),最坏情况为O(n^2)(当输入数组已经有序或逆序时),但可以通过随机化基准选择来避免最坏情况。
空间复杂度:O(log n)(递归调用栈的空间开销)
稳定性:不稳定
7、堆排序(Heap Sort):
堆排序是利用堆这种数据结构所设计的一种排序算法。堆是一个近似完全二叉树的结构,并同时满足堆积的性质:即子结点的键值或索引总是小于(或者大于)它的父节点。
时间复杂度:O(n log n)(平均、最坏和最好情况)
空间复杂度:O(1)(原地排序,不需要额外的空间)
稳定性:不稳定
8、计数排序(Counting Sort)、桶排序(Bucket Sort)和基数排序(Radix Sort):
这三种排序算法都是线性时间复杂度的排序算法,但它们通常用于特定类型的输入数据。
计数排序适用于元素取值范围相对较小的情况。
桶排序通过将元素分配到多个桶中,然后对每个桶分别进行排序。
基数排序则是按照元素的位数来逐位进行排序。
时间复杂度:O(n+k)(计数排序和桶排序,k为元素取值范围大小),O(n*k)(基数排序,k为位数)
空间复杂度:O(k)(计数排序和基数排序),O(n+k)(桶排序)
稳定性:都是稳定的排序算法

总的来说,Java中的排序算法种类繁多,每种算法都有其适用的场景和优缺点。在实际应用中,需要根据具体的需求和数据特点来选择最合适的排序算法。
19、abstract class(抽象类)和interface(接口)区别
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
在Java编程语言中,abstract class(抽象类)和interface(接口)对比:

一、定义与用途
抽象类(abstract class)
使用了abstract关键字修饰的类被称为抽象类。
接口(interface)
接口通过interface关键字来声明。
接口主要用于定义类要实现的方法,而不包含具体的实现。
二、成员定义
成员变量
抽象类:可以包含普通成员变量,这些变量的访问类型可以是任意的(如public、protected、默认访问修饰符等)。
接口:只能包含静态的、不可变的成员变量(即常量),这些变量默认使用public static final修饰。
方法
抽象类:可以包含抽象方法和具体方法。
接口:只能包含抽象方法或缺省方法、类方法。
构造方法
抽象类:可以有构造方法,但构造方法不能用来创建抽象类的实例,只能被子类调用。
接口:不能有构造方法。
三、继承与实现
抽象类:一个类只能继承一个抽象类(单继承)。
接口:一个类可以实现多个接口(多实现)。
默认访问修饰符
| 修饰符 | 本类 | 同包 | 子类 | 任意类 |
|---|---|---|---|---|
| private | √ | × | × | × |
| default | √ | √ | × | × |
| protected | √ | √ | √ | × |
| public | √ | √ | √ | √ |
20、String、StringBuffer、StringBuilder区别?
1
2
3
4
5
6
7
8
9
10
String、StringBuffer、StringBuilder在Java中都是用来处理字符串的类,但它们在使用和功能上有一些显著的区别。

一、可变性
String:String类是不可变的,也就是说,String对象一旦被创建,其内容就不能被改变。如果需要对String对象进行修改,实际上是创建了一个新的String对象,并将原来的引用指向新的对象。
StringBuffer:StringBuffer类是可变的,即StringBuffer对象的内容可以直接被修改,而不需要创建新的对象。
StringBuilder:StringBuilder类也是可变的,与StringBuffer类似,可以直接修改对象的内容。
二、线程安全性
String:由于String是不可变的,因此它是线程安全的。多个线程可以安全地共享同一个String对象而不需要担心并发修改的问题。
StringBuffer:StringBuffer是线程安全的。它的所有方法都被synchronized关键字修饰,以确保在多线程环境中对字符串的修改是安全的。
StringBuilder:StringBuilder不是线程安全的。它的方法没有被synchronized修饰,因此在多线程环境中使用StringBuilder可能会导致数据不一致的问题。
| 可变性 | 线程安全 | |
|---|---|---|
| String | 不可变 | 安全 |
| StringBuffer | 可变 | 安全 |
| StringBuffer | 可变 | 不安全 |
21、字节流和字符流区别?
1
2
3
4
5
6
7
8
9
1、定义与单位:
字节流:以字节(8位)为单位,用于处理二进制数据。
字符流:以字符为单位,处理时涉及字符编码转换。
2、处理对象:
字节流:适用于图片、音频、视频等二进制文件。
字符流:主要处理文本文件,特别是包含非ASCII字符(如中文)的文本。
3、缓冲区:
字节流:通常直接操作文件,不使用或较少使用缓冲区。
字符流:常使用缓冲区以提高效率,关闭时需确保数据刷新到目标。
22、NIO、BIO、AIO区别?
1
2
3
4
5
6
7
8
9
10
11
区别简述:

BIO:
基于流(Stream)进行I/O操作。
每个I/O操作都会阻塞当前线程,直到操作完成。
NIO:
基于通道(Channel)和缓冲区(Buffer)进行I/O操作。
支持非阻塞I/O,通过选择器(Selector)实现I/O多路复用,一个线程可以管理多个通道。
AIO:
异步I/O模型,发起I/O操作后,线程不会被阻塞,而是立即返回继续执行其他任务。
当I/O操作完成时,由操作系统通知应用程序,或通过回调函数进行处理。
23、什么是序列化和反序列化?
1
2
3
4
5
6
7
8
9
序列化和反序列化是:
序列化:将对象转换为可存储或传输的格式(如字节流)。
反序列化:将已存储或传输的格式(如字节流)还原为对象。

序列化的主要目的是:
持久化存储:将对象的状态保存到磁盘上,以便在程序下次运行时能够恢复这些对象的状态。
网络传输:在网络通信中,将对象的状态转换为字节流,然后通过网络发送到远程系统,远程系统再将这些字节流反序列化为对象。

在Java中,通常通过实现Serializable接口并使用ObjectOutputStream(序列化)和ObjectInputStream(反序列化)来完成这一过程。
24、List、Set、Map区别?
1
2
3
4
5
6
7
8
9
10
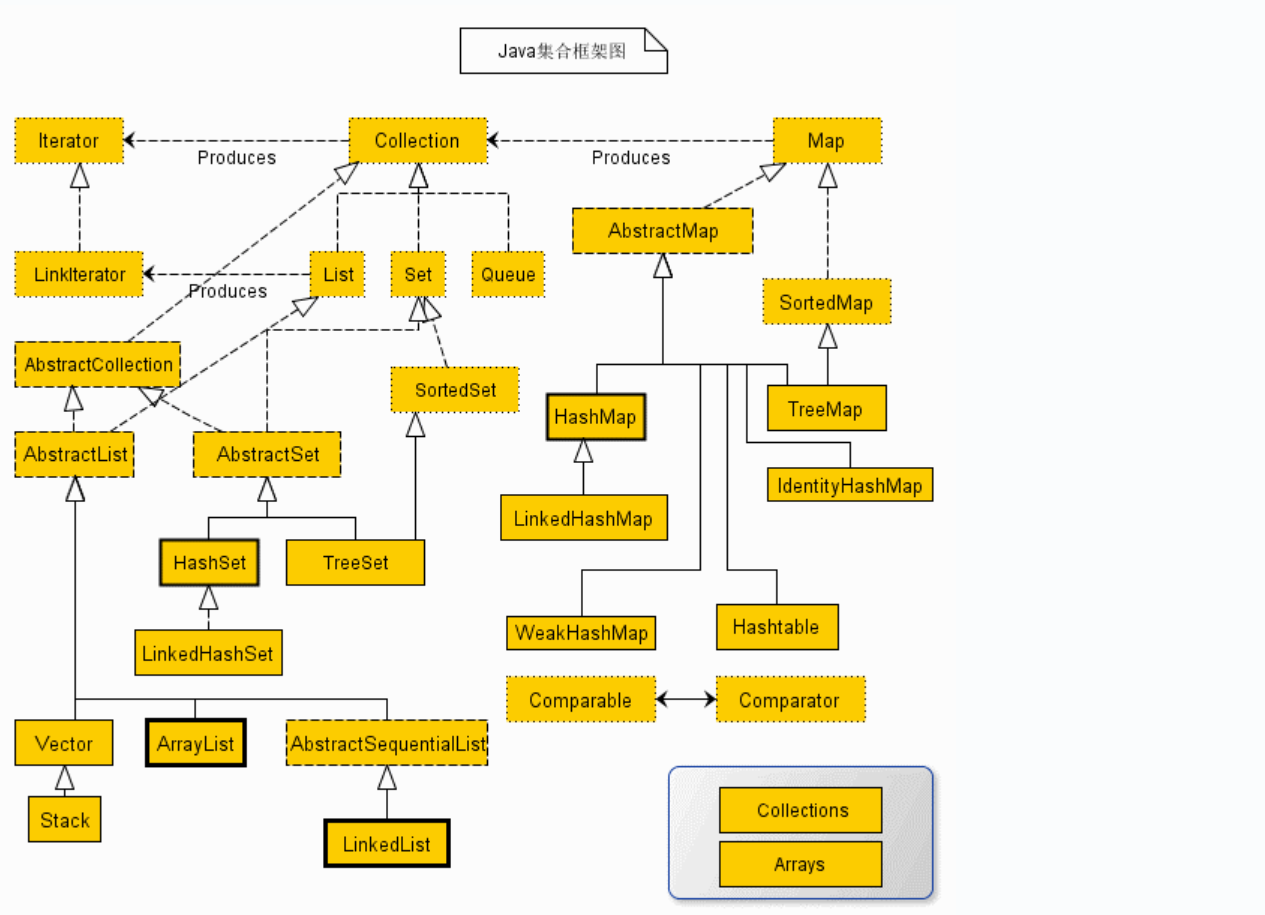
List、Set、Map区别简述:

List:有序集合,允许重复元素,可通过索引访问。
Set:无序集合,不允许重复元素,无索引访问。
Map:键值对集合,键唯一,值可重复,通过键访问值。


List实现类:ArrayList、Vector、LinkedList。
Set实现类:HashSet、LinkedHashSet、TreeSet。
Map实现类:HashMap、Hashtable、LinkedHashMap、TreeMap。
25、ArrayList、LinkedList、Vector 的区别?
1
2
3
4
5
6
7
8
9
10
11
12
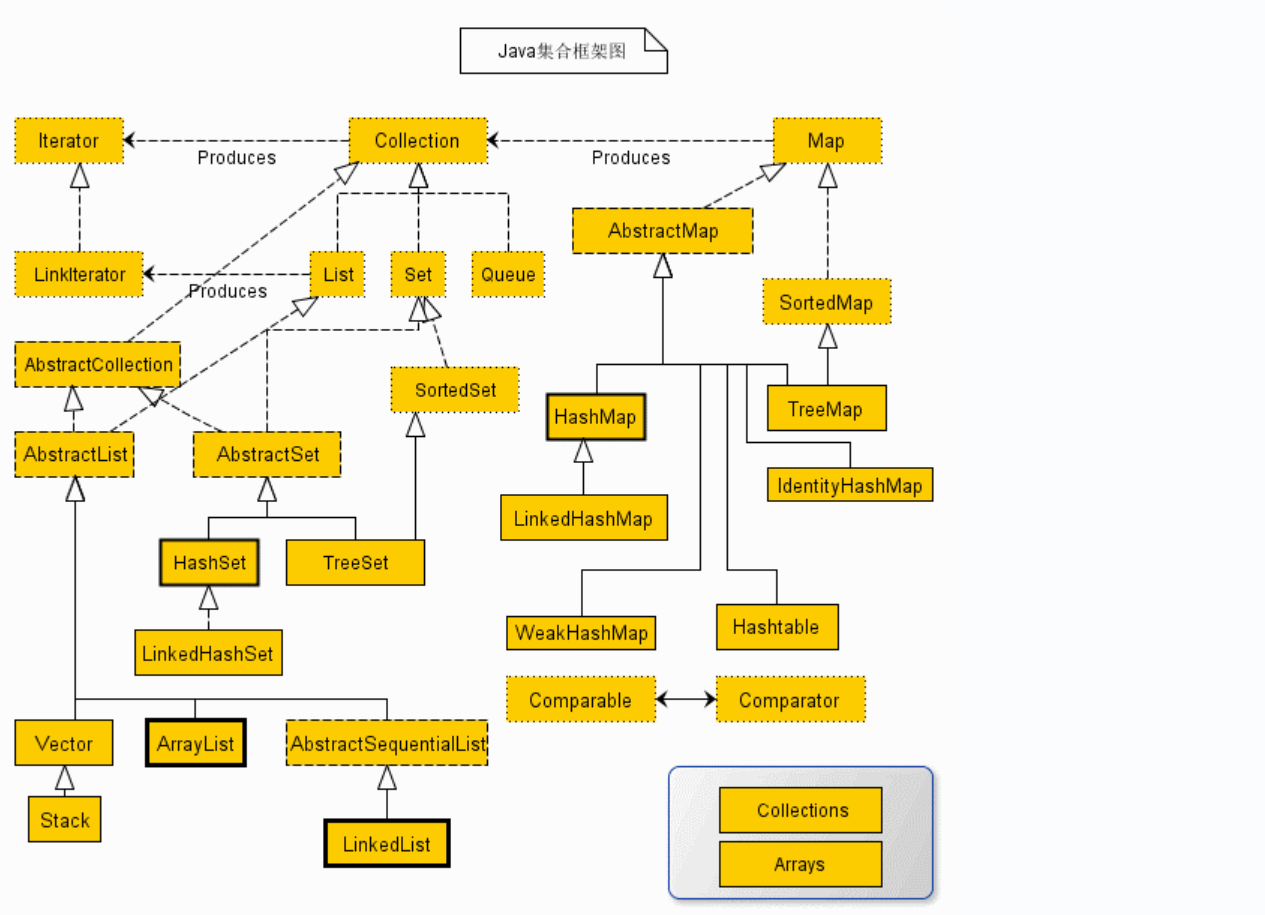
1、底层数据结构:
ArrayList:基于动态数组实现,元素在内存中连续存储。
LinkedList:基于双向链表实现,元素通过节点连接,节点包含数据和指向前后节点的引用。
Vector:与ArrayList类似,也是基于动态数组实现,但Vector是线程安全的。
2、线程安全性:
ArrayList:非线程安全,多线程环境下使用时需要外部同步。
LinkedList:非线程安全,同样需要外部同步来保证线程安全。
Vector:线程安全,方法调用上加了同步锁,但性能会受到影响。
3、性能:
ArrayList:在随机访问和遍历方面表现较好,因为元素在内存中连续存储,可以直接通过索引访问。但在插入和删除元素时,可能需要移动大量元素,性能较低。
LinkedList:在插入和删除元素时表现较好,因为只需要修改相邻节点的引用。但随机访问元素时需要遍历链表,性能较低。
Vector:由于线程同步的开销,性能通常不如ArrayList。
26、HashSet、LinkedHashSet、TreeSet区别?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
HashSet:
元素无序:不保证元素的存储顺序和遍历顺序。
不允许重复元素:通过hashCode()和equals()方法确保元素的唯一性。
存储方式:基于哈希表实现,使用数组+链表+红黑树(JDK 8及以后)的结构来存储元素。
允许null元素:可以存储一个null元素。
性能:提供O(1)时间复杂度的基本操作(插入、删除、判断是否存在等)。
LinkedHashSet:
元素有序:保证元素的存储顺序和遍历顺序与插入顺序一致。
不允许重复元素:同样通过hashCode()和equals()方法确保元素的唯一性。
存储方式:基于哈希表实现,并使用双向链表来维护元素的插入顺序。
允许null元素:可以存储一个null元素。
性能:由于需要维护插入顺序,性能略低于HashSet,但遍历元素时具有与HashSet相同的性能。
TreeSet:
元素有序:保证元素按照自然顺序或自定义的比较器进行排序。
不允许重复元素:通过compareTo()方法(实现Comparable接口)或自定义Comparator来确保元素的唯一性。
存储方式:基于红黑树实现,元素按照排序顺序存储在树形结构中。
不允许null元素:因为null无法参与排序,插入null会抛出NullPointerException。
性能:插入、删除和查找元素时具有稳定的性能,时间复杂度通常为O(log n)。
27、HashMap、Hashtable、TreeMap、LinkedHashMap 的区别?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
HashMap:
基于哈希表,无序,允许null键和值,快速查找。
Hashtable:
线程安全版HashMap,不允许null键和值,性能较低。
TreeMap:
基于红黑树,有序,不允许null键,按键排序。
LinkedHashMap:
维护插入或访问顺序,允许null键和值,基于HashMap。


选择时考虑:
快速查找且无序:HashMap。
线程安全:Hashtable(或ConcurrentHashMap)。
按键排序:TreeMap。
保持顺序:LinkedHashMap。
28、HashMap和ConcurrentHashMap 区别?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
HashMap和ConcurrentHashMap的区别:

1、线程安全性:
HashMap:非线程安全,多线程环境下使用时可能会出现数据不一致或死循环等问题。
ConcurrentHashMap:线程安全,通过多种机制(如分段锁、CAS操作等)保证线程安全性,适合高并发环境。
2、并发性能:
HashMap:不支持并发操作,没有同步方法,因此在多线程环境下性能较低。
ConcurrentHashMap:支持并发操作,通过分段锁技术(JDK 1.7)或CAS操作和内置锁机制(JDK 1.8)来提高并发性能,适合高并发读写场景。
3、数据结构:
HashMap:基于哈希表实现,使用数组+链表+红黑树(当链表长度超过阈值时)的结构来存储键值对。
ConcurrentHashMap:同样基于哈希表实现,但内部结构更复杂,使用了分段锁(JDK 1.7)或CAS操作和内置锁机制(JDK 1.8)来维护线程安全。
4、键值对允许的情况:
HashMap:允许一个null键和多个null值。
ConcurrentHashMap:不允许null键和null值,插入时会抛出NullPointerException。
29、HashSet去重原理
1
2
3
4
5
HashSet是Java集合框架中的一个重要类,它基于HashMap实现,用于存储不重复的元素。
HashSet的去重原理主要依赖于两个关键方法:hashCode()和equals()。

自定义对象去重:
对于自定义对象,为了确保HashSet能正确判断对象的唯一性,我们需要重写对象的hashCode()和equals()方法。
30、HashMap的底层原理
1
2
3
4
5
6
7
8
9
10
一、数据结构
HashMap的底层数据结构是一个数组加上链表(在Java 1.8及以后版本中,当链表长度超过一定阈值时,会转化为红黑树以提高检索效率)。数组是HashMap的主干,用于存储链表或红黑树的头节点。每个数组元素(也称为桶或槽)都可以存储一个链表或红黑树,以处理哈希冲突。

二、存储与检索数据
存储数据:当使用put()方法添加键值对时,HashMap首先计算键的哈希值,并找到对应的数组索引。如果该索引处没有元素,则直接将键值对存储在该位置。如果该索引处已有元素(即发生了哈希冲突),则遍历链表(或红黑树),通过equals()方法查找是否已存在相同的键。如果不存在,则在链表(或红黑树)的末尾添加新的键值对。

检索数据:当使用get()方法来获取某个键对应的值时,HashMap首先也会计算该键的哈希值,然后根据该值找到该键值对应在数组中的位置。如果该位置上没有元素,则返回null。如果该位置上有元素,则遍历该位置对应的链表(或红黑树),找到与该键相等的键值对,然后返回该键值对的值。

三、扩容机制
HashMap有一个重要的参数叫负载因子(load factor),它决定了当数组中元素数量超过数组容量的多大比例时会触发扩容操作。默认的负载因子是0.75。当HashMap的元素数量达到数组容量的75%时,HashMap会自动进行扩容操作,通常会将数组容量扩展为原来的2倍。扩容时,HashMap会重新分配一个更大的数组,并将原来的元素重新映射到新的数组中。
31、什么是进程?什么是线程?
1
2
3
4
5
进程(Process)
进程是操作系统进行资源分配和调度的基本单位,它包含了执行一个程序所需要的所有资源。每个进程都有自己独立的内存空间和系统资源,相互之间不会干扰。进程是程序的一次执行过程,它包括了程序的代码、数据和执行上下文(如程序计数器、堆栈等)。

线程(Thread)
线程是进程中的一个执行单元,它负责在进程内执行代码。一个进程可以包含多个线程,这些线程共享进程的内存空间和系统资源。线程是CPU调度的基本单位,操作系统通过调度线程来执行程序中的指令。
32、线程的创建方式有哪些?
1
2
3
4
5
6
Java中线程的创建方式主要有:

1、继承Thread类:重写run方法,创建子类实例后调用start方法。
2、实现Runnable接口:实现run方法,将实例作为Thread对象的target,然后调用start方法。
3、实现Callable接口并使用FutureTask:允许线程有返回值,并可以抛出异常。
4、使用线程池:通过ExecutorService接口管理线程池,提交任务执行。
33、线程并发问题的解决方式有哪些?
1
2
3
4
5
6
7
8
9
10
11
12
13
解决线程并发问题的方式主要包括:

同步机制:
	使用synchronized关键字,同步块,或同步方法;
	使用Lock接口来确保同一时间只有一个线程访问共享资源。
原子类:
	利用java.util.concurrent.atomic包中的原子类实现无锁并发。
volatile关键字:
	确保变量的可见性,但无法解决原子性问题。
ThreadLocal:
	为每个线程提供独立的变量副本,避免数据共享问题。
并发集合:
	使用线程安全的集合类,如ConcurrentHashMap。
34、什么情况下会产生死锁,如何解决?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
死锁是指两个或多个进程(线程)相互等待对方持有的资源,导致无法继续执行的情况。

产生死锁需要满足以下四个必要条件:
1、互斥条件:某种资源一次只允许一个进程访问,即该资源一旦分配给某个进程,其他进程就不能再访问,直到该进程访问结束。
2、占有且等待条件:一个进程本身占有资源(一种或多种),同时还有资源未得到满足,正在等待其他进程释放该资源。
3、不可抢占条件:别人已经占有了某项资源,你不能因为自己也需要该资源,就去把别人的资源抢过来。
4、循环等待条件:存在一个进程链,使得每个进程都占有下一个进程所需的至少一种资源。
当以上四个条件均满足时,必然会造成死锁。


解决死锁问题可以采取以下策略:
1、预防死锁
破坏互斥条件:尝试通过SPOOLing技术将资源变得可共享,但这种方法并非万能,因为并非所有资源都能轻松改造,且可行性较低。
破坏占有且等待条件:如果请求不到资源,立即放弃已持有的资源。但这种方法实现复杂,且可能导致工作失效、增加系统开销。
破坏不可抢占条件:操作系统帮助进程“强制夺回”资源,但可能导致优先级、饥饿等问题。
破坏循环等待条件:规定所有线程必须按照相同的顺序获取锁,或者运行前分配好所有资源。但这种方法编程难度大,且容易造成资源浪费。
2、避免死锁
银行家算法:在分配资源前进行安全性检查,只有当资源分配不会导致系统进入不安全状态时才分配资源。
顺序加锁:规定所有线程必须按照相同的顺序获取锁,避免不同线程因加锁顺序不同而发生死锁。
3、检测和恢复死锁
死锁检测:通过检测系统中是否存在死锁来判断是否需要采取措施恢复系统的正常运行。
死锁恢复:通过中断某些进程、回滚某些操作等方式来解除死锁。恢复策略包括终止所有的死锁进程(简单粗暴但代价大)或逐个终止进程直至死锁状态解除(代价也大,需要死锁检测)。
35、wait和sleep区别?
1
2
3
4
5
6
7
8
9
10
11
12
1、所属类
wait():wait是Object类的方法。
sleep():sleep是Thread类的静态方法。
2、释放锁
wait():调用wait方法时,线程会释放它所占有的对象锁,这使得其他线程可以访问该对象。
sleep():调用sleep方法时,线程不会释放它所占有的锁,这意味着其他线程无法访问被该线程锁定的资源。
3、线程状态
wait():调用无参数的wait方法时,线程会进入WAITING(无时限等待)状态。如果指定了超时时间,线程会在超时后自动唤醒,但在此之前,它处于TIMED_WAITING(有时限等待)状态。不过,这两种状态都属于等待状态。
sleep():调用sleep方法的线程会进入TIMED_WAITING(有时限等待)状态,在指定的睡眠时间到期后,线程会自动返回到可运行状态。
4、异常处理
wait():调用wait方法时不需要捕获异常,但如果线程在wait过程中被中断,会抛出InterruptedException异常。不过,这个异常是在wait方法执行完毕后,通过线程的中断状态来检查的,因此不需要在wait方法的声明中捕获它。
sleep():调用sleep方法时必须捕获InterruptedException异常,因为当线程在睡眠过程中被中断时,会立即抛出这个异常。
36、线程的生命周期和状态
1
2
3
4
5
6
7
8
9
10
11
12
13
14
1、NEW(新建状态)
线程对象已经创建,但尚未启动。
2、RUNNABLE(可运行状态/运行状态)
线程已经启动,正在Java虚拟机中执行。RUNNABLE状态是线程的主要执行状态,它包括了两种子状态:就绪(Ready)和运行(Running)。
就绪状态:线程已经具备了执行条件,但尚未被调度执行。它处于线程队列中,等待操作系统的调度。
运行状态:线程正在处理器的执行单元上运行,执行其run()方法中的代码。
3、BLOCKED(阻塞状态)
线程因为试图获取某个对象的监视器锁(synchronized锁)而失败,进入阻塞状态。当其他线程释放该锁时,线程可能重新进入RUNNABLE状态。
4、WAITING(等待状态)
线程在等待另一个线程执行特定的动作。这通常涉及到线程间的通信,如调用Object.wait()方法等待另一个线程调用Object.notify()或Object.notifyAll()方法。处于WAITING状态的线程不会竞争CPU资源,也不会被调度执行。
5、TIMED_WAITING(计时等待状态)
与WAITING状态类似,但线程等待的时间是有限的。这通常通过调用带有超时参数的Thread.sleep()、Object.wait()或Thread.join()等方法来实现。当超时时间到达或线程被中断时,它将重新进入RUNNABLE状态。
6、TERMINATED(终止状态)
线程已经执行完毕或因异常而终止。
37、什么是JUC?
1
2
3
4
5
6
7
JUC是java.util.concurrent的缩写,它是Java提供的一个用于处理并发编程的工具包。

JUC中的关键组件和功能包括:
1、线程池:提供了可调的、灵活的线程池实现,如ExecutorService、ThreadPoolExecutor等,允许开发者以更高效的方式管理和复用线程资源。
2、同步机制:提供了多种同步机制,如Lock接口及其实现类(如ReentrantLock)、ReadWriteLock接口及其实现类(如ReentrantReadWriteLock)、Semaphore(信号量)、CountDownLatch(倒计时门栓)和CyclicBarrier(循环栅栏)等,用于控制多个线程之间的执行顺序和并发访问。
3、原子操作:提供了原子变量类(如AtomicInteger、AtomicLong、AtomicReference等),这些类通过利用底层的硬件指令来实现对变量的原子操作,从而避免了在多线程环境下使用同步机制所带来的性能开销。
4、并发集合:提供了一系列设计用于多线程上下文中的集合实现,如ConcurrentHashMap、CopyOnWriteArrayList等,这些集合类通过内部机制保证了在多线程环境下的线程安全性和高并发性能。
38、常见的线程池有哪些?
1
2
3
4
5
6
7
以下是Java提供的线程池:
SingleThreadExecutor:单一线程池,任务按顺序串行执行,保证任务顺序。
FixedThreadPool:固定数量的线程池,适用于负载较重的服务器,资源利用合理。
CachedThreadPool:缓存线程池,适合执行大量短期异步任务,动态调整线程数量。
ScheduledThreadPool:定时线程池,支持定时或周期性执行任务。

这些线程池都位于Java的java.util.concurrent包中,开发者可以根据实际需求选择合适的线程池类型。
39、如何自定义线程池?有哪些参数?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
主要参数及其解释:
1、核心线程数(corePoolSize):
线程池中始终存在的线程数,即使它们处于空闲状态,也不会被销毁(除非设置了allowCoreThreadTimeOut)。
2、最大线程数(maximumPoolSize):
线程池中允许的最大线程数。当工作队列满了,且已创建的线程数小于最大线程数时,线程池会创建新的线程来处理任务。
3、空闲线程存活时间(keepAliveTime):
非核心线程空闲时的存活时间。当线程池中的线程数大于核心线程数时,多余的线程如果在指定时间内没有被使用,则会销毁。
4、时间单位(unit):
与空闲线程存活时间配合使用的单位,如秒(TimeUnit.SECONDS)、分钟(TimeUnit.MINUTES)等。
5、工作队列(workQueue):
用于存放待执行的任务。当所有核心线程都在忙时,新提交的任务会放入工作队列中等待执行。常用的工作队列实现有ArrayBlockingQueue、LinkedBlockingQueue、SynchronousQueue等。
6、线程工厂(threadFactory):
用于创建新线程的工厂。通过自定义线程工厂,可以给创建的线程设置一些属性,如线程名称、线程组、优先级等。Executors.defaultThreadFactory()提供了一个默认的线程工厂实现。
7、拒绝策略(handler):
当线程池和队列都满了时,新提交的任务的处理方式。

Java提供了几种内置的拒绝策略:
(1)AbortPolicy:
抛出RejectedExecutionException异常。
(2)CallerRunsPolicy:
直接在调用者线程中运行被拒绝的任务。
(3)DiscardPolicy:
静默地丢弃被拒绝的任务,不抛出异常。
(4)DiscardOldestPolicy:
丢弃工作队列中最旧的任务,然后尝试重新提交被拒绝的任务。
40、线程池工作原理?
1
2
3
4
5
6
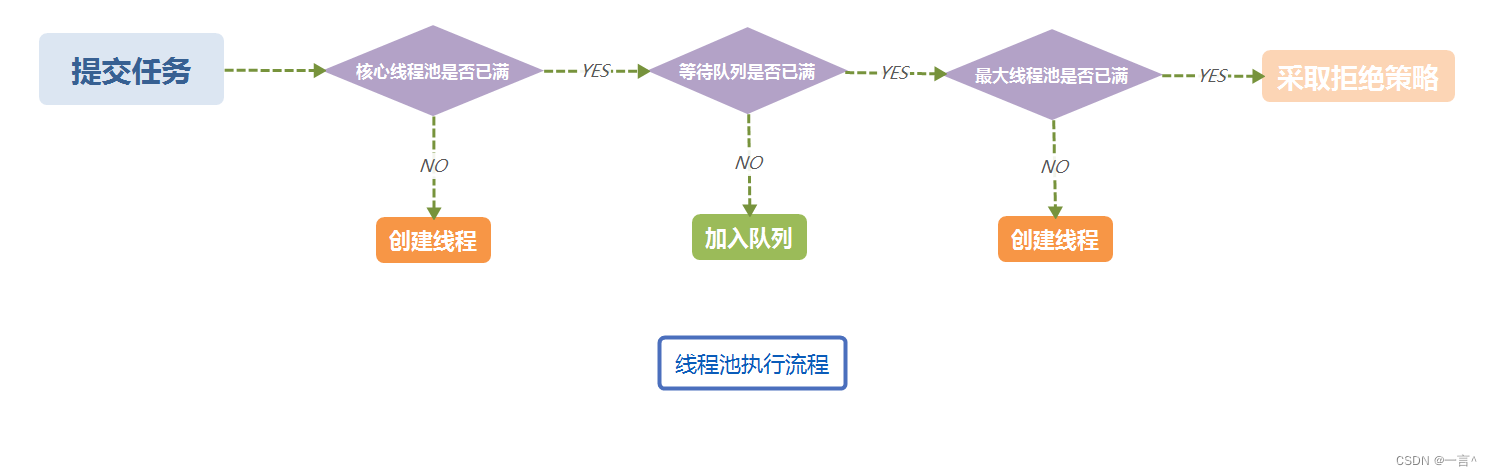
线程池的执行流程:
1、当任务提交到线程池时,假如当前线程数小于核心线程数,直接创建线程执行,并且不会销毁,直到达到核心线程数。
2、当核心线程都在执行但是还有任务提交时,任务放在阻塞队列中。
3、阻塞队列也满了以后,继续创建线程执行任务,直到达到最大线程数。
4、最大线程也满了以后,执行设定的的拒绝策略。
5、当线程空闲下来以后,线程在达到线程空闲等待时间后销毁,直至数量降低至核心线程数。
41、多线程start方法和run方法的区别?
1
2
3
4
5
6
7
8
9
10
11
12
在Java多线程中,start方法和run方法的关键区别在于:

1、start方法:
启动一个新线程,异步执行run方法中的代码。
由JVM调用run方法,创建独立调用堆栈。
一个线程只能被start一次。
2、run方法:
包含线程的执行逻辑。
直接调用run方法不会启动新线程,而是在当前线程中同步执行。
异常处理与普通方法相同。

简单来说,start方法是启动线程并让JVM异步执行run方法,而直接调用run方法则是在当前线程中同步执行其逻辑。
42、JVM的内存模型介绍一下,jdk1.8有什么变化?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
JVM内存模型主要分为两大类:线程私有和线程共享。

1、线程私有:每个线程独立拥有,随线程创建而创建,随线程消亡而消亡。
包括:
(1)虚拟机栈:
描述的是Java方法执行的内存模型,生命周期与线程相同。每个方法执行的同时都会创建一个栈帧结构,方法执行过程对应着虚拟机栈的入栈到出栈的过程。栈帧是用于支持虚拟机进行方法执行的数据结构,是属性运行时数据区的虚拟机栈的栈元素。栈帧中包括局部变量表、操作数栈、动态链接、方法出口信息等。局部变量表主要存放的是编译期间可知的各种数据类型(八大基本数据类型)、对象引用(Reference类型,不同于对象,可能是指向对象地址的指针或者与此对象位置相关的信息)。
(2)本地方法栈:
为虚拟机使用到的Native方法服务。在HotSpot虚拟机中,本地方法栈与虚拟机栈合二为一。本地方法被执行的时候,在本地方法栈也会创建一个栈帧,用于存放该本地方法的局部变量表、操作数栈、动态链接、出口信息。
(3)程序计数器:
一块较小的内存空间,可以看作是当前线程所执行的字节码的行号指示器。每条线程都需要有一个独立的程序计数器,各线程之间计数器互不影响,独立存储。字节码解释器工作时就是通过改变这个计数器的值来选取下一条需要执行的字节码指令,分支、循环、跳转、异常处理、线程恢复等基础功能都需要依赖这个计数器来完成。程序计数器是唯一一个不会出现OutOfMemoryError的内存区域。

2、线程共享:多个线程共同拥有,随JVM创建而创建,随JVM消亡而消亡。包括:
(1)Java堆:
JVM所管理的内存中最大的一块,所有线程共享的一块内存区域,在虚拟机启动时创建。存放对象实例和数组,几乎所有的对象实例以及数组都在这里分配内存。堆的大小可以通过-Xms(堆的最小值/初始值)和-Xmx(堆的最大值)参数来调整。物理上不连续,逻辑上连续。堆是垃圾收集器管理的主要区域,因此也被称作GC堆(Garbage Collected Heap)。从内存回收角度,Java堆被分为新生代和老年代,新生代采用复制算法收集内存,老年代采用标记-整理算法。从内存分配角度,Java堆可以划分出线程私有的分配缓冲区(Thread Local Allocation Buffer,TLAB),以更快地分配内存。
(2)方法区:
也叫永久代(PermGen,在Java 8之前使用)或元空间(Metaspace,在Java 8及之后使用)。是JVM规范中定义的一个用于存储已被虚拟机加载的类信息、常量、静态变量、即时编译器编译后的代码等数据的区域。线程共享,存储的信息比较持久,生命周期与JVM一致。方法区的大小可以通过JVM参数来调整。


JDK 1.8的变化
1、方法区移至元空间:
在JDK 1.8及之后的版本中,方法区被移至直接内存中,并被称为元空间(Metaspace)。这一变化使得方法区不再受限于JVM堆内存的大小,而是受本机可用内存的控制。
2、使用参数调整元空间大小:
在JDK 1.8中,可以使用-XX:MetaspaceSize和-XX:MaxMetaspaceSize参数来设置元空间的初始大小和最大大小。如果不设置参数,则只受本机总内存的限制。
43、Java的类加载器有哪些?
1
2
3
4
5
6
7
8
9
10
11
12
1、启动类加载器(Bootstrap ClassLoader):
负责加载Java的核心类库(如rt.jar)。
是JVM自带的类加载器,用C++编写,直接集成在JVM中。
没有父加载器。
2、扩展类加载器(Extension ClassLoader):
负责加载Java的扩展类库,通常是lib/ext目录下的扩展类。
是Bootstrap ClassLoader的子级。
3、应用程序类加载器(Application ClassLoader):
负责加载用户类路径(classpath)下的类文件,通常是应用程序代码。
是Extension ClassLoader的子级。
4、自定义类加载器:
开发者可以继承ClassLoader来编写自己的类加载器,用于特定场景下加载自定义的类。
44、什么是双亲委派机制?
1
2
3
4
5
6
7
双亲委派机制是Java类加载器的一种工作机制,即“向上委托,向下加载”:
当一个类加载器需要加载一个类时,它不会立即自己去加载这个类,而是先将其加载请求委派给它的父类加载器去完成。这个过程会一直递归进行,直到最顶层的启动类加载器(Bootstrap ClassLoader)。如果父类加载器能够加载这个类,那么加载过程就结束;如果父类加载器无法加载(即找不到这个类),那么子类加载器才会尝试自己去加载这个类。

这种机制的好处是:
1、避免重复加载:确保同一个类只会被加载一次,避免内存浪费。
2、保证类的唯一性:在JVM中,每个类都是由一个类加载器加载的,因此保证了类的唯一性。
3、提高安全性:防止恶意代码被加载到JVM中,因为恶意代码很难通过父类加载器加载。
45、Java 类加载器的加载过程?
1
2
3
4
5
6
7
8
9
10
11
12
13
类加载的过程
(1)加载:查找并加载类的二进制数据。
读取字节码文件,在方法区开辟空间保存类的元信息(类名,Class对象的引用==)。
在堆中创建一个对应的Class对象,保存类中的构造器、属性、方法定义信息。

(2)链接:
验证:确保被加载的类的正确性。
准备:为类分配内存,并初始化静态变量。
	在方法区中,为常量属性分配空间并初始化;为静态属性分配空间,并赋予缺省值(没有初始化)。
解析:将类中的符号引用转换为直接引用。

(3)初始化:为类的静态变量赋予正确的初始值。
	给静态属性初始化(属性的赋值语句,静态块)
46、JVM 的 GC 垃圾回收机制?(判断垃圾的算法,垃圾清除的算法)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59

GC是Java虚拟机提供的一种自动内存管理机制,它负责监测内存中不再使用的对象,并将它们自动回收以释放内存资源。这可以减少内存泄漏和程序崩溃的风险,但同时也可能引入一些性能开销。

1、判断垃圾的算法
JVM中判断垃圾对象的算法主要有两种:引用计数法和可达性分析算法。
(1)引用计数法
每个对象在创建的时候,都会绑定一个计数器(引用计数器)。
每当有一个引用指向该对象时,计数器加一;每当有一个指向它的引用被删除时,计数器减一。
当没有引用指向该对象时(计数器为0),该对象被视为垃圾,可以被GC回收。
缺点:无法处理循环引用的问题。
(2)可达性分析算法
将一系列GC Root对象作为搜索起点。
如果在GC Root和一个对象之间没有可达的路径,则该对象被认为是不可访问的(即垃圾对象)。
GC Root对象通常包括全局变量、静态变量、活跃线程的局部变量等。

2、垃圾清除的算法
JVM中垃圾清除的算法主要有标记清除算法、复制算法、标记整理算法和分代收集算法等。
(1)标记清除算法
分为标记和清除两个阶段。
标记阶段:从GC Root开始遍历对象图,标记所有可达对象。
清除阶段:遍历堆内存,清除未被标记的对象,释放其内存。
缺点:可能导致内存碎片化。
(2)复制算法
将堆内存划分为大小相等的两块区域(通常称为From区和To区)。
活动对象在From区分配,当From区满时,将存活对象复制到To区,并清空From区。
然后交换From区和To区的角色,继续下一次分配。
优点:解决了内存碎片化问题。
缺点:内存利用率低(只有一半内存可用),且复制存活对象的开销较大。
(3)标记整理算法
标记阶段与标记清除算法相同。
整理阶段:将所有存活对象压缩到内存的一端,并释放另一端的所有内存。
优点:解决了内存碎片化问题,同时提高了内存利用率。
(4)分代收集算法
基于对象的生命周期长短将堆内存划分为不同的区域(如新生代和老年代)。
新生代对象存活时间短,使用复制算法进行垃圾回收。
老年代对象存活时间长,使用标记清除或标记整理算法进行垃圾回收。
优点:根据不同区域的特点选择不同的算法,提高了垃圾回收的效率。

3、GC回收器
JVM提供了多种GC回收器,如Serial GC、Parallel GC、CMS GC和G1 GC等。每种回收器都有其特点和适用场景。

Serial GC
单线程GC回收器,适用于小型应用或单CPU环境。
新生代使用复制算法,老年代使用标记清除算法。
Parallel GC
多线程GC回收器,适用于多CPU环境。
新生代使用复制算法,老年代使用标记清除算法。
提高了垃圾回收的并行度,缩短了垃圾回收时间。
CMS GC
以获取最短回收停顿时间为目标的GC回收器。
新生代使用复制算法,老年代使用标记清除算法并增加了并发标记和并发清除阶段。
适用于对停顿时间要求较高的应用。
G1 GC
面向服务端应用的垃圾收集器。
将堆内存划分为多个大小相同的区域(Region),并优先回收垃圾最多的区域。
结合了标记清除和标记整理算法,适用于大堆内存和低延迟应用。

选择合适的GC回收器和算法:根据应用的需求和硬件环境选择合适的GC回收器和算法。
47、jvm如何调优?
1
2
3
4
5
6
7
8
9
10
11
JVM调优旨在提升Java应用程序的性能和稳定性,以下是一些关键步骤和策略:

1、明确性能目标:
确定你希望优化的方面,如吞吐量、延迟、内存使用或稳定性。
2、调整JVM参数:
设置合理的堆内存大小(-Xms和-Xmx)。
根据应用需求选择合适的垃圾收集器(如G1、CMS、Parallel GC等)。
调整新生代和老年代的比例(-XX:NewRatio和-XX:SurvivorRatio)。
3、启用GC日志(-Xloggc)以便后续分析。
4、使用工具如jconsole、VisualVM、MAT、GCeasy等进行性能监控。
48、JDK 1.8新特性
1
2
3
4
5
6
7
8
9
JDK 1.8(也称为Java 8)引入了许多新特性和改进,以下是一些主要的新特性:

1、Lambda表达式:允许以更为简洁和直观的方式编写函数式接口,使得代码更加容易阅读和理解。Lambda表达式可以看作是一个匿名函数,它实现了函数式接口的抽象方法。
2、Stream API:提供了对集合和数组数据的高效且功能强大的处理方式,可以用来进行大量数据集的筛选、过滤、变换等操作。Stream API使得开发者可以以声明式的方式处理数据,提高了代码的可读性和可维护性。
3、新的Date and Time API:解决了旧的java.util.Date和java.util.Calendar类设计上的问题,提供了更加方便和安全的日期时间操作方式。新的API包括LocalDate、LocalTime、LocalDateTime、Instant等类,提供了丰富的日期时间处理功能。
4、接口中的默认方法:在JDK 1.8中,接口可以包含具有默认实现的方法。这允许在不破坏现有实现的情况下向接口添加新方法,从而提供了更灵活的接口扩展方式。
5、方法引用:方法引用是一种简化Lambda表达式的语法,可以用来引用已经存在的方法。方法引用使得代码更加简洁,并提高了可读性。
6、PermGen空间移除:JDK 1.8中移除了永久代(PermGen)空间,用元空间(MetaSpace)替代,提供更好的类和元数据存储和管理机制。
7、Optional 类等
49、悲观锁和乐观锁的区别?
1
2
3
4
5
6
7
8
Java中的悲观锁和乐观锁是两种不同的并发控制机制。

1、加锁策略
悲观锁:总是假设最坏的情况,即认为其他线程会修改数据。因此,在读取或操作数据时,会先对数据进行加锁,以保证数据的一致性。
乐观锁:则相反,它认为自己在操作资源时不会有其他线程干扰。因此,不会锁定对象,只是在更新资源时会去对比一下自己修改过的数据之间是否有其他线程修改过的数据。
2、实现方式
悲观锁:通常是通过在读取或操作数据时加锁来实现的,如使用synchronized或ReentrantLock等。
乐观锁:通常是通过版本号控制或CAS(Compare and Swap/Set)算法等机制来实现。例如,在更新数据时,会检查当前版本号与期望值是否相同,如果相同则进行更新(期间加锁保证原子性),否则继续重试。
50、什么是Java反射机制?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
Java反射机制允许程序在运行时动态地获取类的信息、调用方法、访问字段和创建实例,主要通过java.lang.reflect包实现。它增强了程序的灵活性,但可能带来性能开销和安全问题。反射常用于框架、动态代理、注解处理和反序列化等场景。

Java反射机制主要通过以下核心类和方法实现:
1、Class类:表示类和接口的元数据。通过Class对象,可以获取类的各种信息,并操作类的成员。
getName():获取类的名称。
getSuperclass():获取类的父类。
getInterfaces():获取类实现的接口。
getDeclaredConstructors():获取类的所有构造方法。
getDeclaredFields():获取类的所有字段。
getDeclaredMethods():获取类的所有方法。
2、Constructor类:表示类的构造方法。通过Constructor对象,可以创建类的实例。
newInstance():使用构造方法创建类的实例(注意:此方法在Java 9及以上版本已被弃用,建议使用Constructor.newInstance(Object... initargs))。
3、Field类:表示类的成员变量。通过Field对象,可以访问和修改类的字段。
get(Object obj):获取指定对象上此Field表示的字段的值。
set(Object obj, Object value):将指定对象上此Field表示的字段的值设为指定的新值。
4、Method类:表示类的方法。通过Method对象,可以调用类的方法。
invoke(Object obj, Object... args):对带有指定参数的指定对象调用此Method对象表示的方法。
This post is licensed under CC BY 4.0 by the author.